文書前処理設定
MinerU や Doc2x などの外部 OCR サービスを設定し、スキャン文書や複雑な表の解析精度を向上させます。
なぜ必要か
このモジュールは 知識ベース の解析能力を強化します。標準のパーサーでは PDF の複雑な表・数式・スキャン画像が扱えないことがあります。OCR 連携で認識率を大幅に向上できます。
- 未設定: PDF のテキスト層のみ抽出。スキャン PDF は読めません。
- 設定後: 外部 OCR とレイアウト解析を使用し、表/数式を保持。
設定手順
- システム設定 > 文書前処理設定 を開く。
- プロバイダー(
MinerU/Doc2x)を選択。 - API 情報を入力。
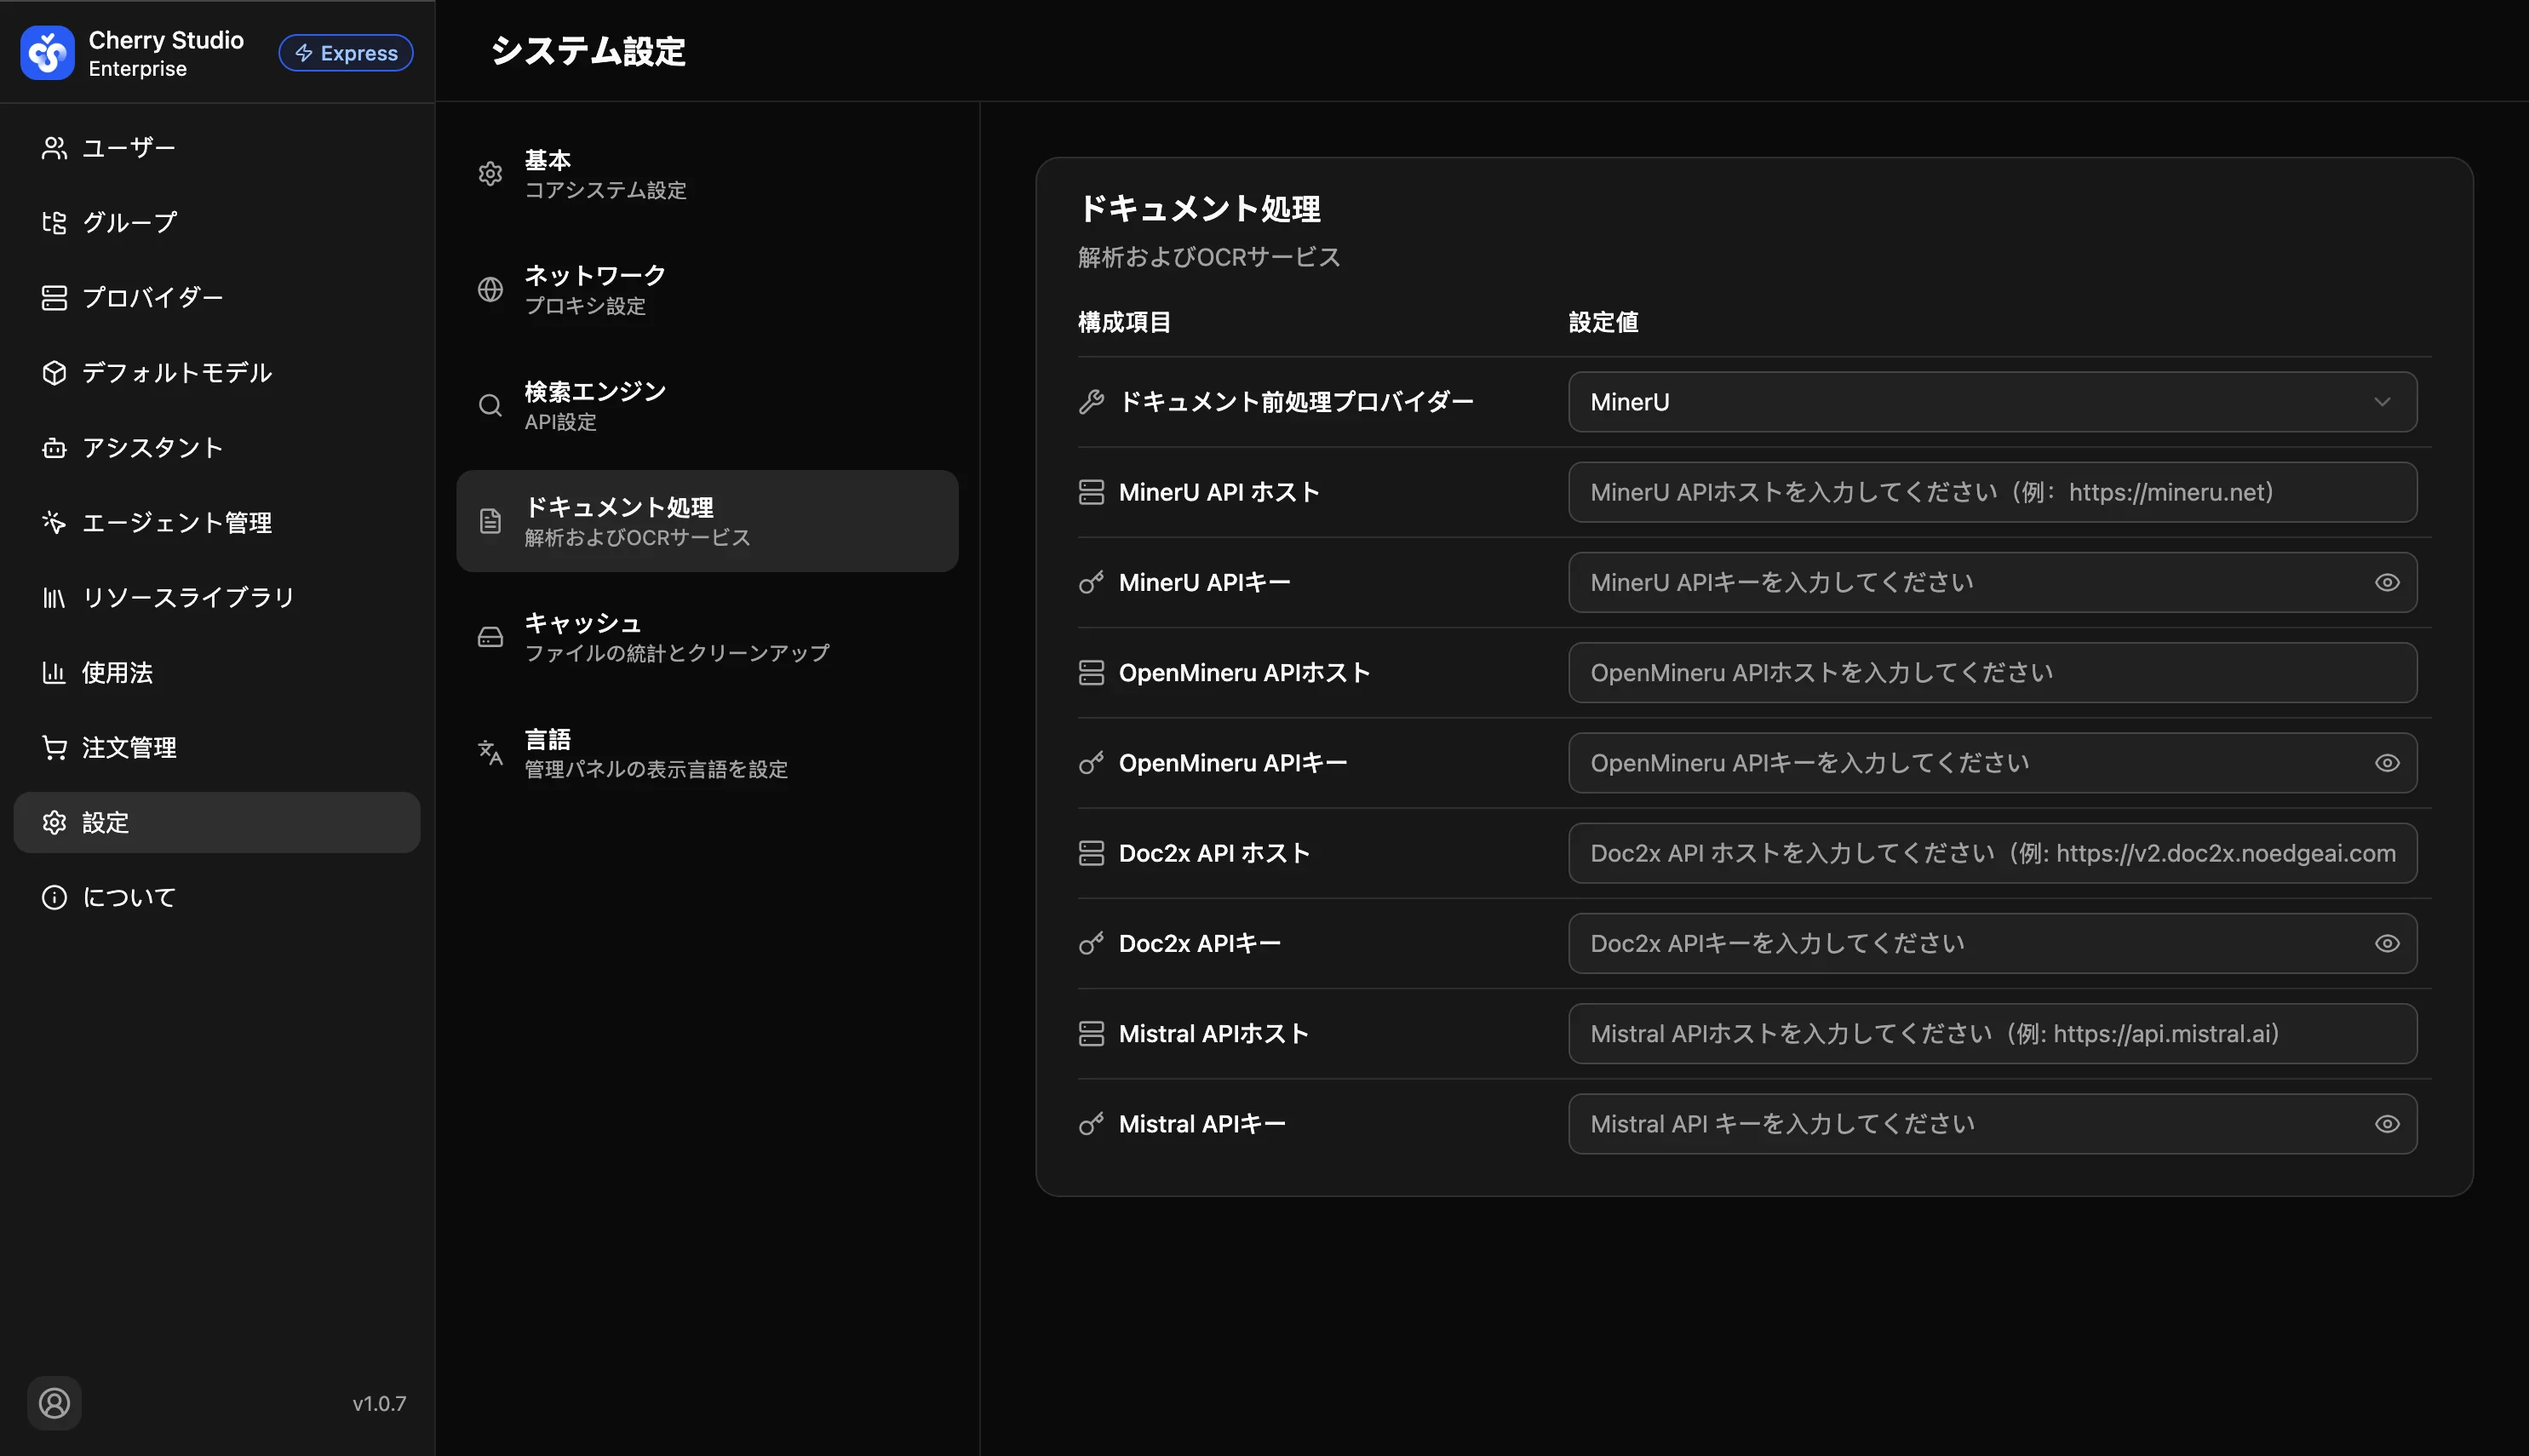
パラメータ説明
| パラメータ | 説明 | 例 |
|---|---|---|
| 文書前処理プロバイダー | 解析エンジンの選択 | MinerU / Doc2x |
| API Host | サービスのエンドポイント | MinerU 既定: https://minerU.net(例) |
| API Key | 認証キー | sk-... |
利用シーン: 設定後は追加操作不要です。知識ベースに PDF をアップロードすると自動で適用されます。