创建与基础配置
新建知识库并配置嵌入模型、分块大小等核心参数,为文档检索和 AI 问答奠定基础。
入口路径: 管理后台 → 资源库 → 知识库 → 点击右上角 + 添加知识库 按钮
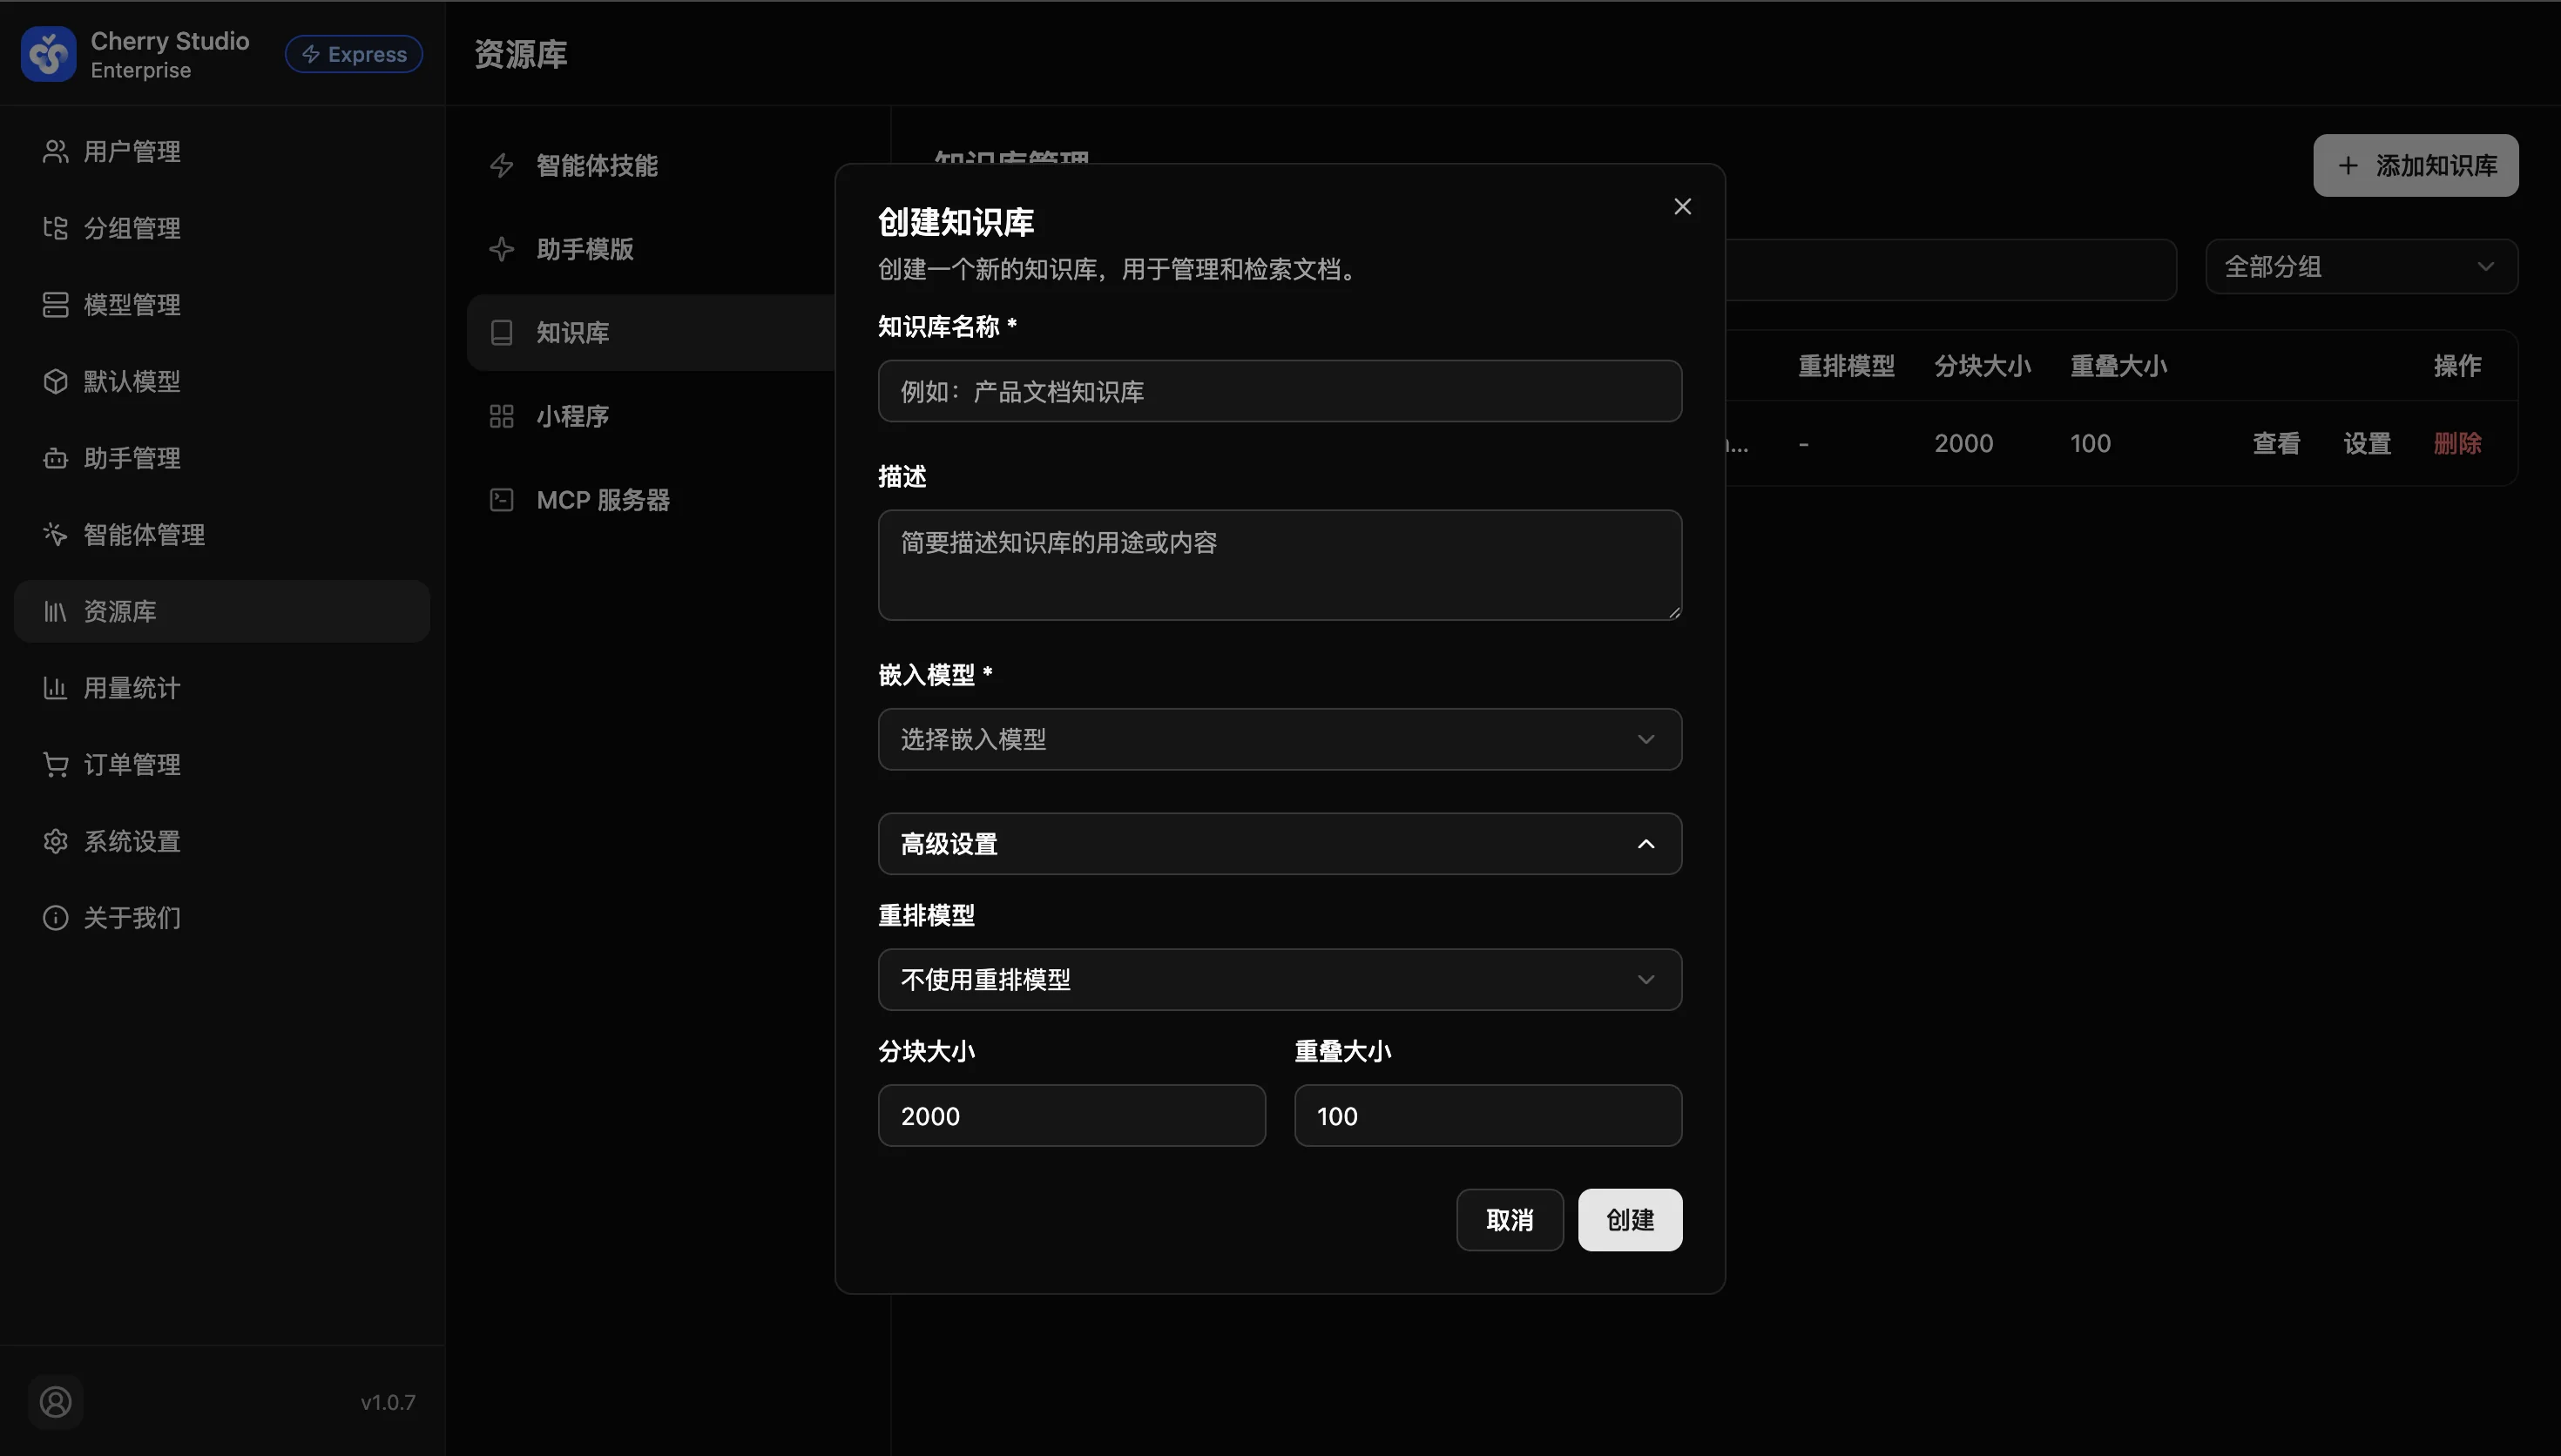
基础参数
| 参数名称 | 必填 | 说明 |
|---|---|---|
| 知识库名称 | 是 | 建议使用具有业务辨识度的名称,如产品技术文档、员工手册 2024。 |
| 描述 | 否 | 简要说明库内数据的范围,便于其他管理员协作识别。 |
| 嵌入模型 (Embedding) | 是 | 核心参数。负责将文本转化为计算机可理解的向量数据。建议选择支持多语言且维度较高的模型(如 bge-m3 或 text-embedding-v3)。 |
注意: 知识库创建后,嵌入模型 (Embedding) 通常不可直接变更。因为不同模型的向量空间不兼容,若需更换,通常需要重建知识库并重新索引所有文档。
高级设置 (Advanced Settings)
点击 高级设置 展开折叠项,这些参数直接影响检索的颗粒度和准确性。
| 参数 | 推荐值 | 深度释义 |
|---|---|---|
| 重排模型 (Rerank) | 按需开启 | 二次精筛。Embedding 模型负责初筛(找得快),Rerank 模型负责对初筛结果进行深度语义打分(找得准)。 建议: 对准确率要求极高的场景(如法律、医疗)强烈建议开启。 |
| 分块大小 (Chunk Size) | 800 - 1500 | 模型一次性读取的文本字符数。块太小可能丢失上下文逻辑;块太大可能包含无关噪声。 |
| 重叠大小 (Overlap) | 100 - 200 | 相邻分块之间的重复字符数。用于确保句子不会在关键处被切断,保持语义连贯性。 建议: 设为分块大小的 10%-15%。 |
配置建议:
- 通用文档: Chunk: 1000 / Overlap: 100
- 代码/技术文档: Chunk: 1500 / Overlap: 200 (代码逻辑较长)
- 碎片化问答: Chunk: 500 / Overlap: 50