服务商管理 (阿里云百炼/Qwen)
阿里云百炼(通义千问/Qwen)服务商的配置与管理,包括 API Key 激活、模型启用和自定义模型添加。
概述
入口路径: 管理后台 → 服务商管理
Cherry Studio 企业版默认集成了 阿里云百炼 (Aliyun Bailian) 作为核心模型引擎。系统预置了标准的 OpenAI 兼容协议配置,企业无需繁琐的参数调试,仅需填入 API Key 即可一键解锁通义千问(Qwen)全系列模型及百炼托管的高性能开源模型。
默认策略与扩展性
- 默认状态:系统初始状态下,仅显示"阿里云百炼"这一个服务商。
- 扩展能力:支持管理员手动添加其他服务商(如 本地 Ollama),实现多渠道模型聚合。
激活默认服务商
系统列表中已存在 "阿里云百炼" 卡片。
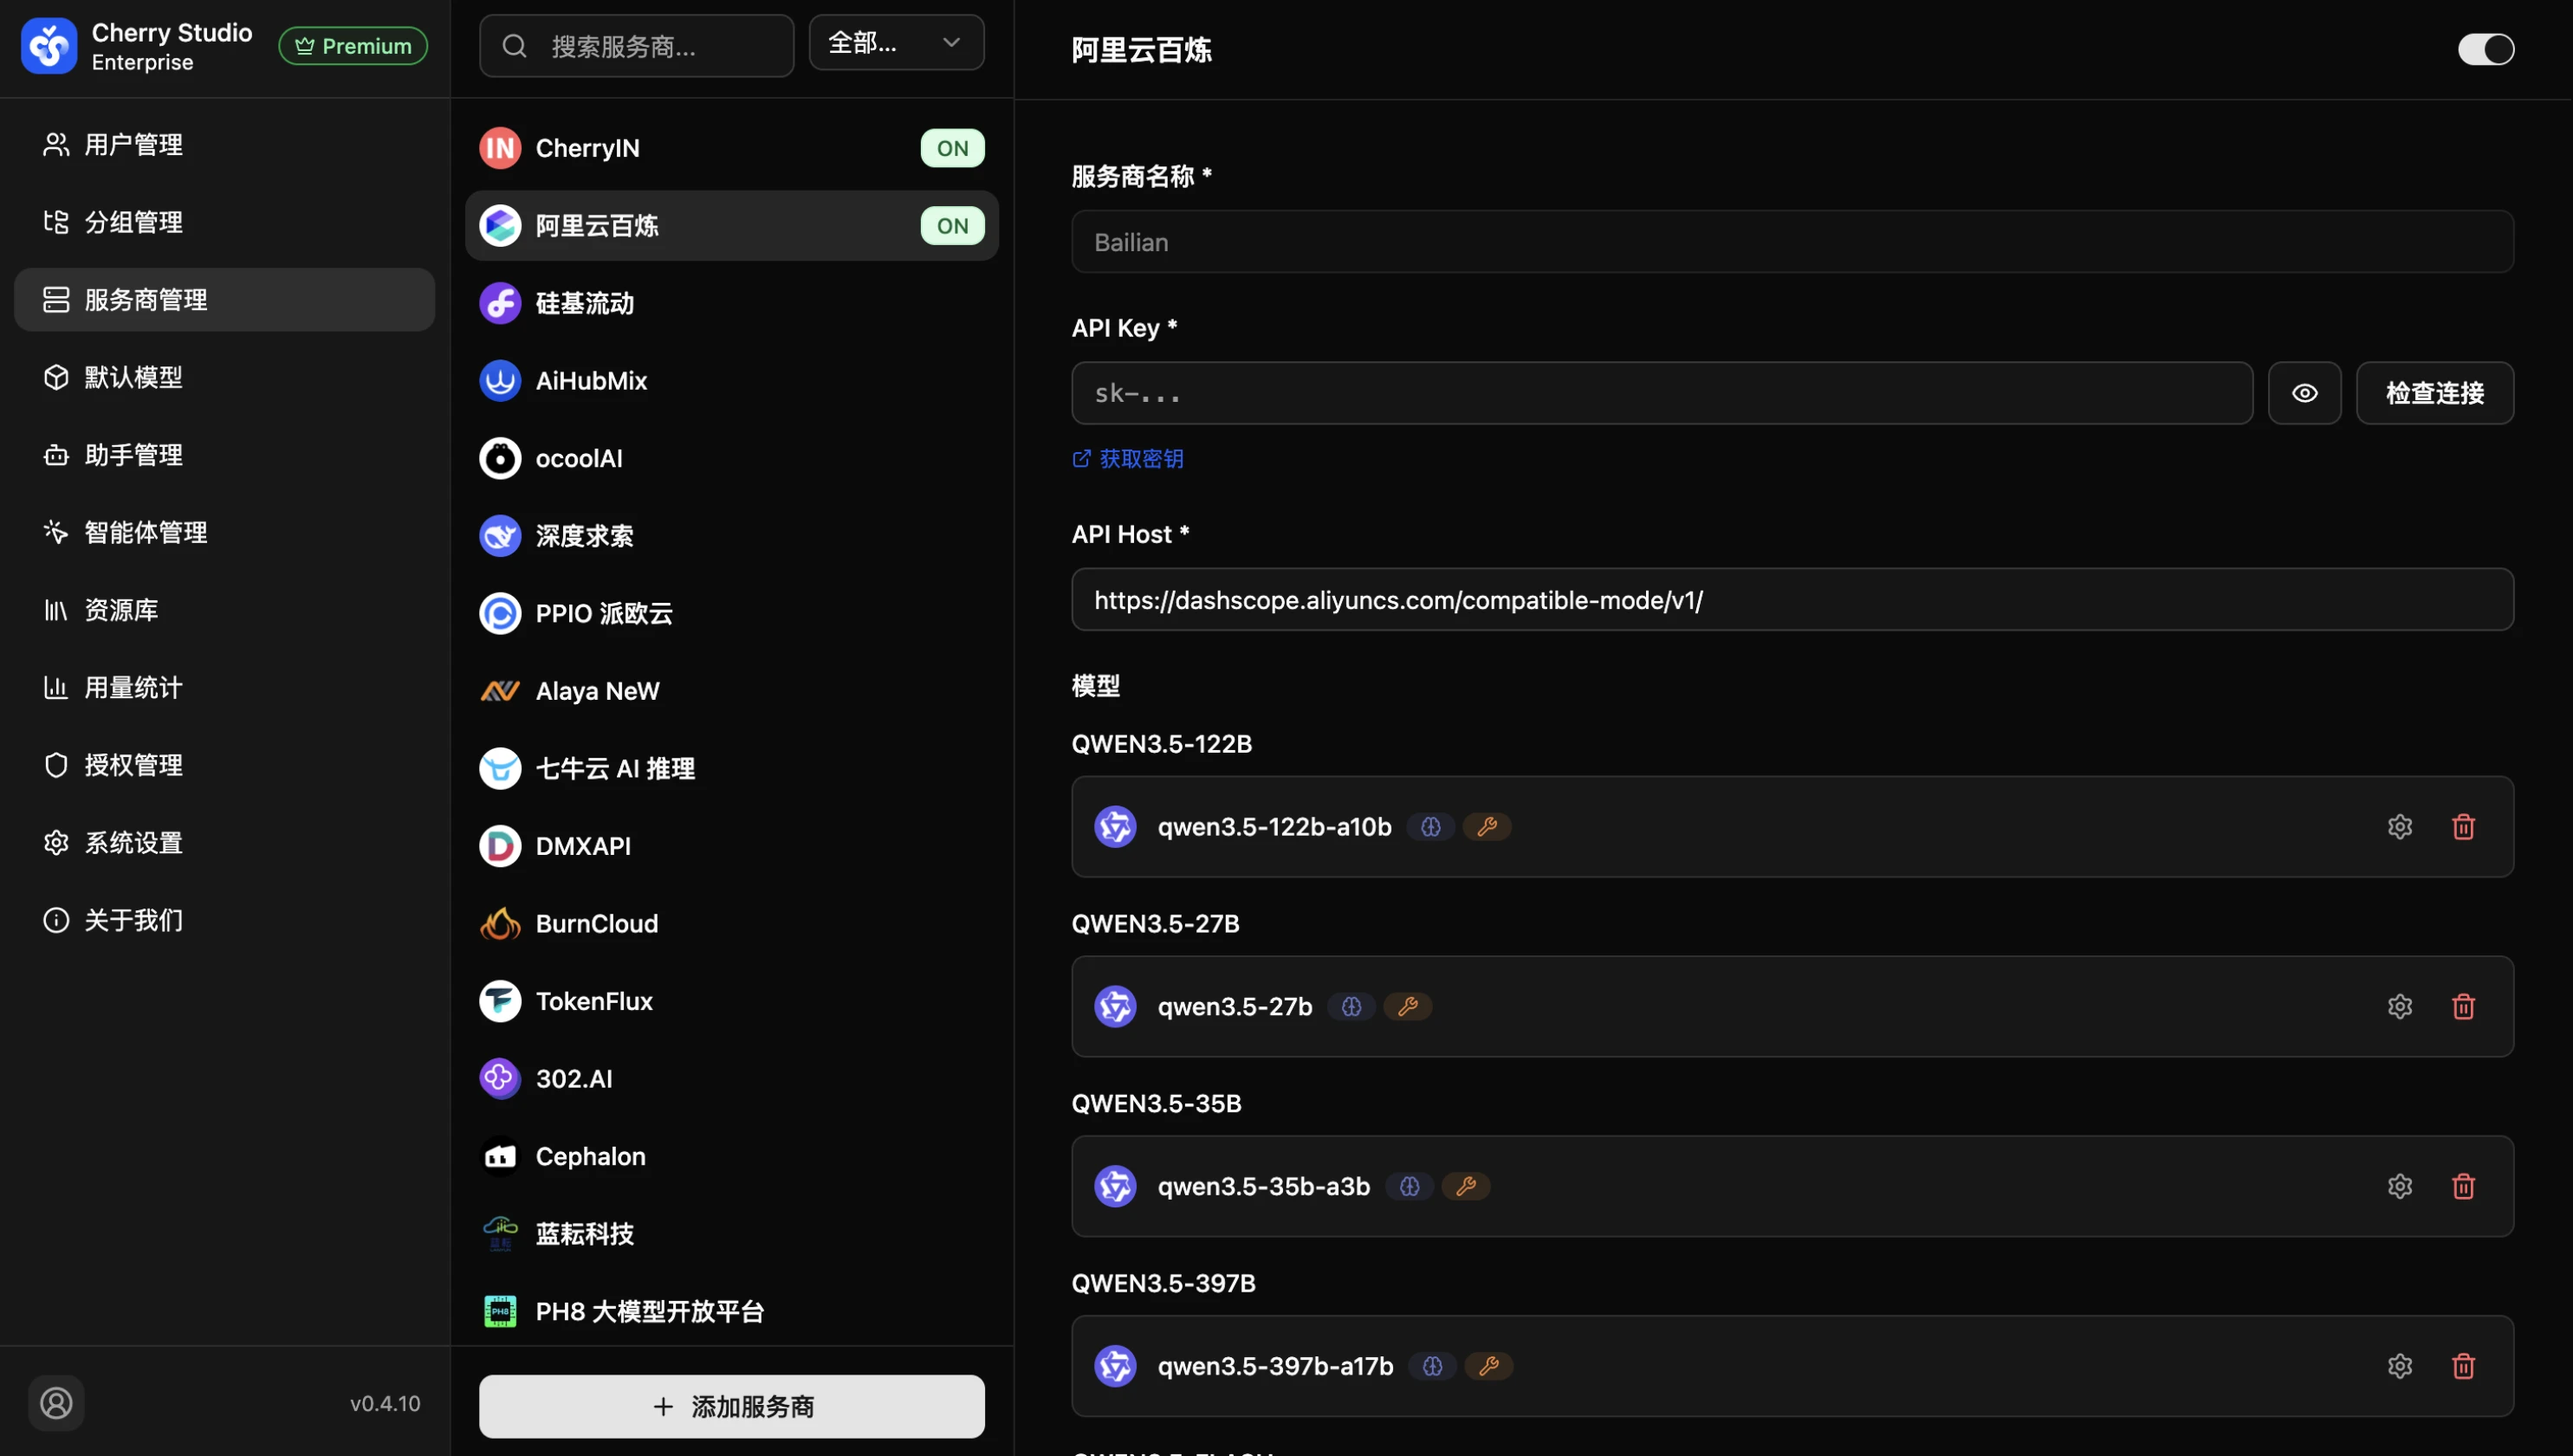
- 点击 阿里云百炼 卡片,并点击右上角按钮开启该服务商。
- API Key:填入从阿里云百炼控制台获取的密钥(以
sk-开头)。 - API Host:保持系统默认值。
- 地址:
https://dashscope.aliyuncs.com/compatible-mode/v1
- 地址:
- 点击 检查连接,确保提示"API Key 有效"。
- 点击 保存。
模型体系详解
根据百炼最新的 API 策略,Cherry Studio 将模型资源分为两大阵营。理解这两类模型的区别,有助于管理员为不同部门分配资源。
A. 通义千问(商业/闭源版)
位于模型列表顶部的核心区域,代表了阿里最强的模型能力。
| 模型系列 | 典型 ID | 适用场景 | 建议配置 |
|---|---|---|---|
| 顶配版 (Max) | qwen3-maxqwen3-max-2026-01-23 | 复杂任务主力。262K 上下文,逻辑推理、长文写作、深度指令遵循。当前主力商用 Qwen 模型。 | ✅ 推荐作为高管/核心团队的默认模型。 |
| 均衡版 (Plus) | qwen3.6-plusqwen3.5-plus | 性价比首选。1M 上下文,速度快于 Max,成本大幅降低,支持智能体编排。 | ✅ 推荐作为全员通用的默认模型。 |
| 轻量版 (Flash) | qwen3.5-flash | 极致低成本。1M 上下文,适合简单问答、分类、摘要等轻量任务。 | 💡 适合高频低复杂度场景。 |
| 推理版 (QwQ) | qwq-plus | 深度思考。专门针对数学、代码、复杂逻辑链优化的推理模型。 | 🧠 适合研发或数据分析部门。 |
| 代码版 (Coder) | qwen3-coder-plusqwen3-coder-flash | 编程专用。1M 上下文,支持代码生成、审查、重构等开发任务。 | 💻 适合研发团队。 |
| 视觉版 (VL) | qwen3-vl-plusqwen3-vl-flash | 图像理解。262K 上下文,支持图片识别、OCR、图表分析。 | 👁️ 需要图片分析时启用。 |
| 长文本 (Long) | qwen-long | 超大文档分析。10M 上下文,适合整本 PDF 的摘要或问答。 | 🔧 超长文档场景使用。 |
关于 Turbo 系列:qwen-turbo 已停止更新,由 qwen3.5-flash 替代。如仍在使用 Turbo,建议迁移至 Flash。
B. 通义千问开源系列(托管版)
阿里云百炼精选并托管的开源模型,运行在企业级 GPU 集群上,无需本地显卡。
| 模型系列 | 典型 ID | 特点 |
|---|---|---|
| Qwen 3.5 | qwen3.5-397b-a17bqwen3.5-27b | 当前最强开源。397B MoE 架构,Apache 2.0 协议,性能接近商业模型。 |
| Qwen 3 | qwen3-235b-a22bqwen3-32bqwen3-8b | 主力开源代。参数覆盖 0.6B~235B,支持思考/非思考双模式切换。 |
| Qwen 2.5 | qwen2.5-72b-instructqwen2.5-32b-instruct | 上一代开源。仍可用,适合已有部署兼容。 |
| Qwen 2 / 1.5 | qwen2-72b-instructqwen1.5-110b-chat | 历史版本。提供向下兼容支持。 |
关于版本号 (Dates) 您在列表中会看到如 qwen3-max-2026-01-23 的日期后缀版本。
- 最佳实践:除非业务代码强依赖某个特定日期的模型表现,否则建议直接使用不带日期的 ID(如
qwen3-max或qwen3.6-plus),系统会自动指向最新稳定版 (latest)。
管理模型列表
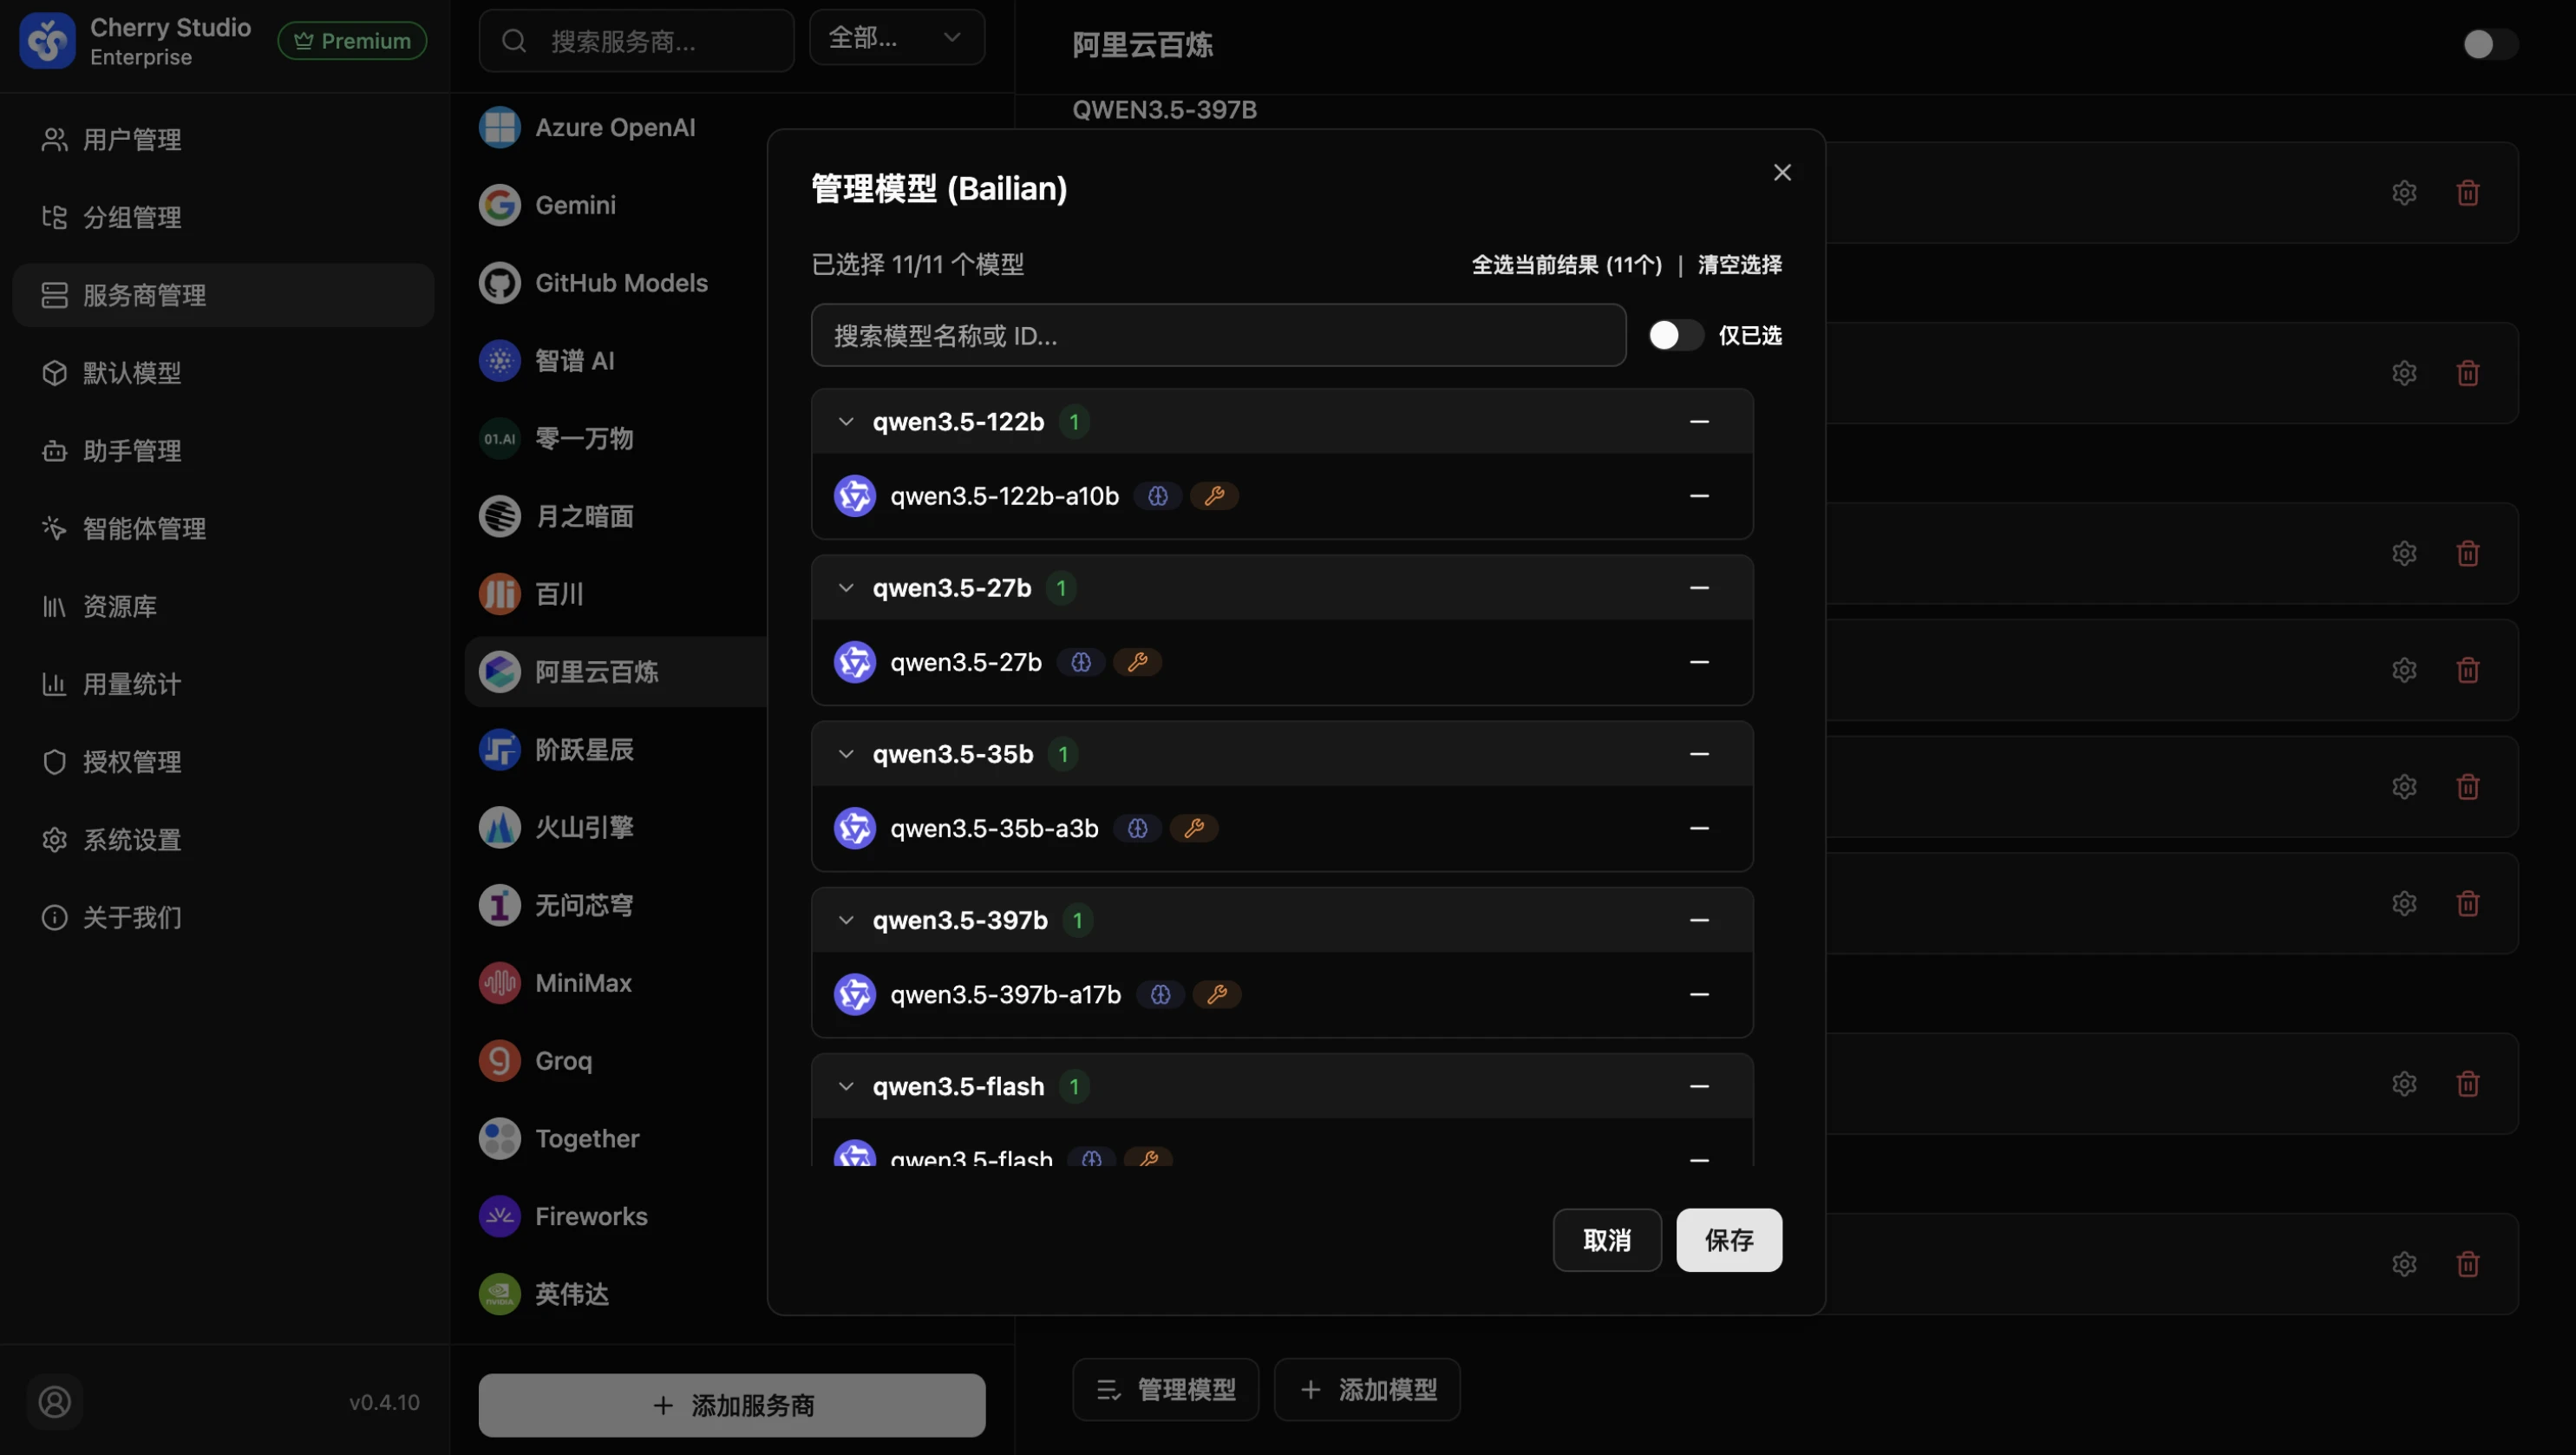
百炼提供的模型列表非常长(如上图所示),为了避免员工选择困难,管理员应进行精简。
- 点击百炼卡片下的 𝌡 管理模型。
- 筛选策略:
- 保留
qwen3-max和qwen3.6-plus(当前主力商用模型)。 - 保留
qwq-plus(用于推理任务)。 - 保留
qwen3-coder-plus(研发专用)。 - 保留
qwen3.5-flash(轻量高频任务)。 - 按需保留
qwen3-32b或qwen3-8b(开源替代方案)。
- 保留
- 隐藏冗余:将旧版模型(如
qwen-max、qwen-plus)、带旧日期或过小参数(如0.5b、1.7b)的模型点击 - 号隐藏。 - 点击 保存。
添加其他服务商 (自定义)
虽然百炼是默认供应商,但 Cherry Studio 作为一个聚合平台,完全支持接入其他渠道。
场景举例:
- 您想接入 DeepSeek 官方的
deepseek-v4。 - 您想接入 智谱 GLM 的
glm-5.2。 - 您在本地服务器部署了 Ollama。
操作步骤:
- 在服务商列表底部,点击 + 添加服务商。
- 服务商类型:
- 选择 OpenAI (通用兼容协议,适配绝大多数国内模型)。
- 选择 Anthropic (Anthropic 协议)。
- 选择 Ollama (本地模型)。
- 填写对应的 API Key 和 API Host。
- 例如本地 Ollama Host:
http://192.168.1.5:11434/v1
- 例如本地 Ollama Host:
- 添加后,该服务商的模型将与百炼模型共同出现在用户的模型选择下拉框中。
常见问题 (FAQ)
Q: qwen3-max 和旧版 qwen-max 有什么区别?
A: qwen3-max 是当前主力旗舰模型(262K 上下文),而 qwen-max 指向上一代(Qwen 2.5-Max),仍可用但不再是最优选择。建议新项目直接使用 qwen3-max。
Q: qwq-32b 和 qwq-plus 有什么区别?
A: qwq-32b 是基于开源权重的推理模型,而 qwq-plus 是阿里云自研的商业闭源推理模型,通常后者在逻辑上限和安全性上更高,但成本也相对较高。
Q: qwen-turbo 还能用吗?
A: qwen-turbo 已停止更新,建议迁移至 qwen3.5-flash,后者成本更低、上下文更长(1M)。