文档预处理配置
配置 MinerU 或 Doc2x 等外部 OCR 服务,增强知识库对扫描件和复杂表格的解析能力。
为什么需要配置?
此模块用于增强 知识库 (Knowledge Base) 的解析能力。默认的文本解析器可能无法完美处理 PDF 中的复杂表格、公式或扫描图片。接入专业的 OCR 服务可以显著提升文档识别率。
- 未配置时:系统仅提取 PDF 中的文本层。如果是扫描件(图片型 PDF),系统将无法读取内容。
- 配置后:系统调用外部 API 对文档进行 OCR(光学字符识别)和版面分析,保留表格结构和公式。
配置步骤
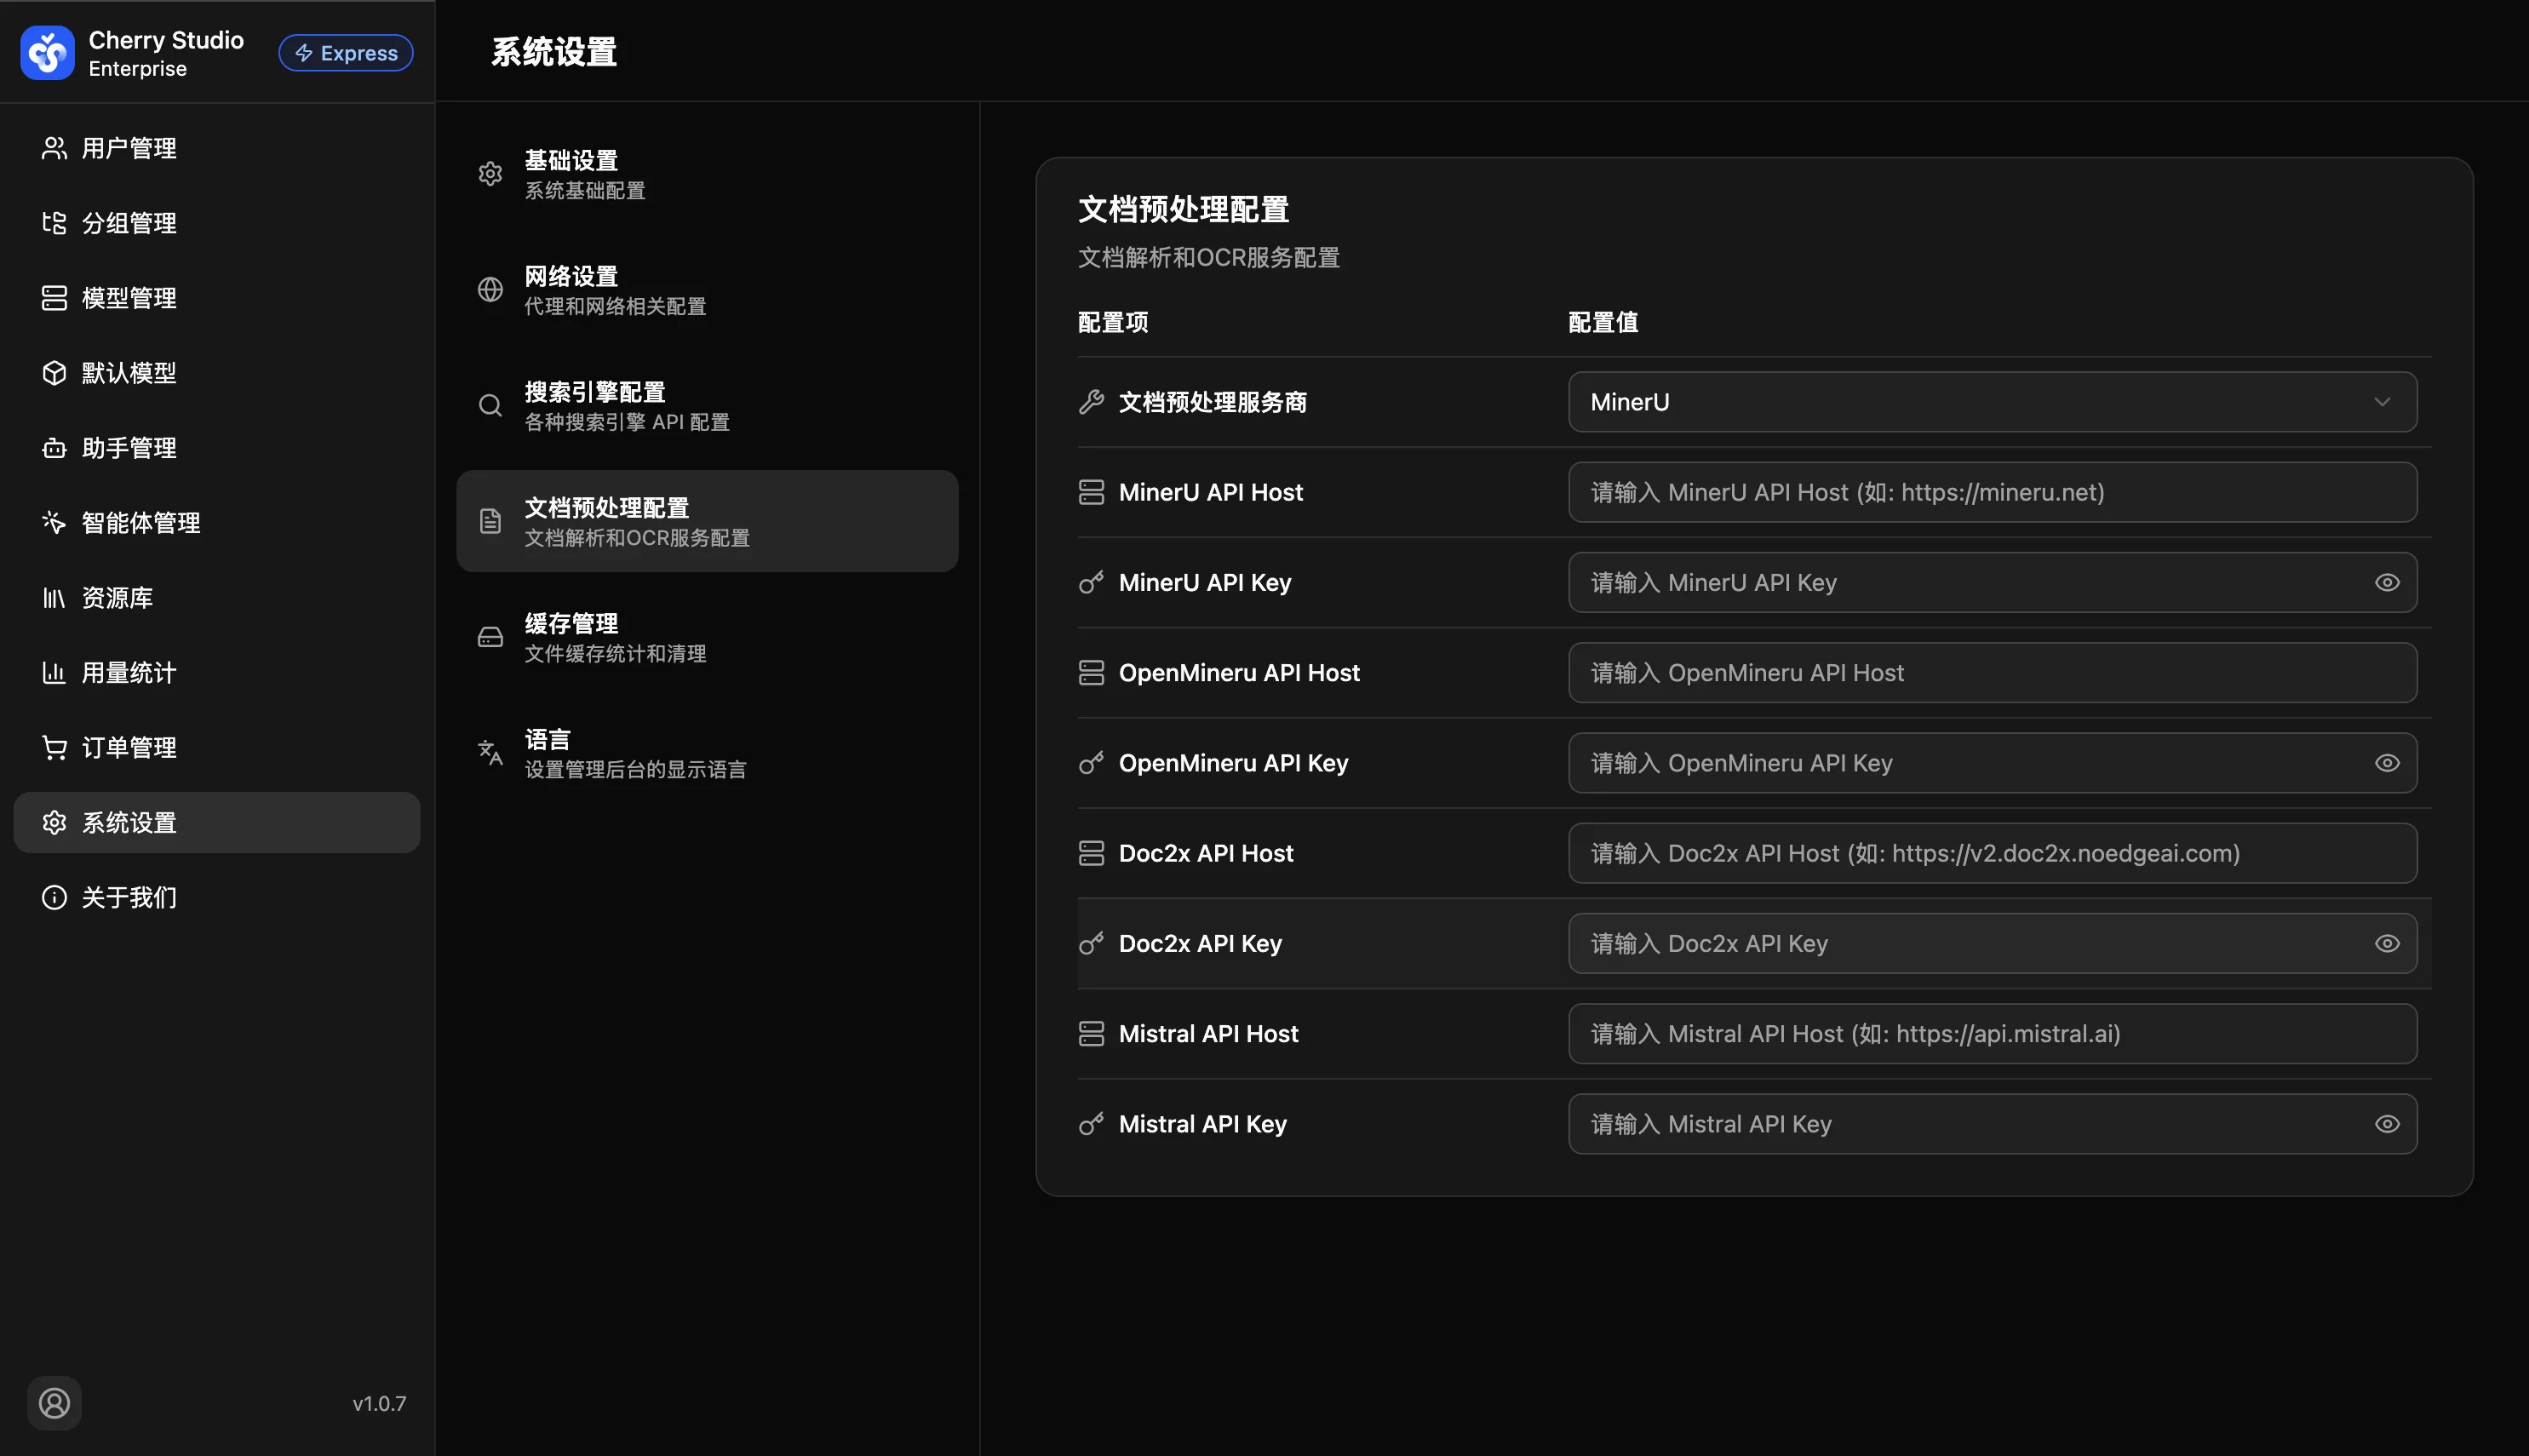
- 导航至 系统设置 > 文档预处理配置。
- 选择您偏好的服务商(
MinerU或Doc2x)。 - 填入对应的 API 信息。
参数说明
| 参数 | 描述 | 示例 |
|---|---|---|
| 文档预处理服务商 | 选择用于解析任务的后端引擎。 | MinerU / Doc2x |
| API Host | 服务接口地址。 | MinerU 默认: https://minerU.net (示例) |
| API Key | 鉴权密钥。 | sk-... |
应用场景:配置完成后,无需额外操作。当您在知识库中上传 PDF 文件时,系统会自动应用此处的配置进行解析。